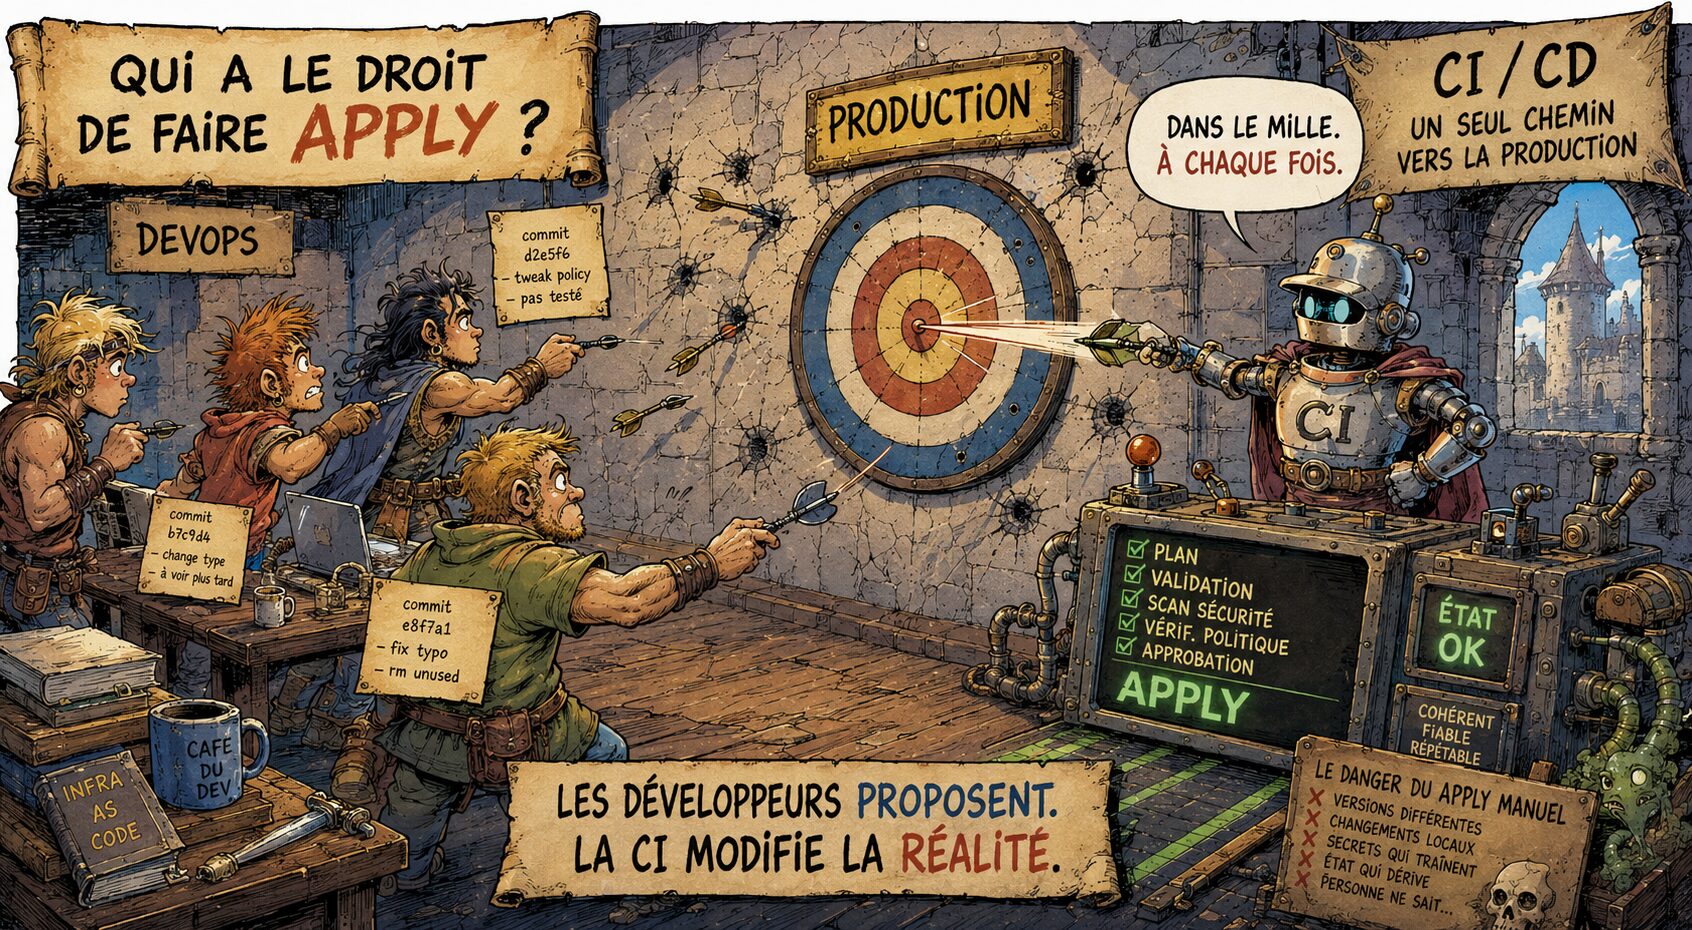
La question a l’air purement technique. Elle ne l’est pas du tout, et c’est pour ça qu’elle traîne dans les équipes pendant des années sans jamais être tranchée.
Dans toutes celles où je suis passé, il y a un moment où quelqu’un la pose. En général le lendemain d’un incident, avec un ton un peu sec. Et la réponse qu’on donne à ce moment-là décide de ce que va valoir votre dépôt Terraform pour les trois ans qui viennent. Je vous explique.
Le symptôme, d’abord
Vous êtes quatre à toucher à l’infrastructure. Chacun a son poste, son profil AWS, sa version de Terraform installée le jour où il en a eu besoin. Personne n’a jamais décidé que ça marcherait comme ça, c’est arrivé tout seul.
Et un matin, ça donne ça :
$ terraform plan

Error: Failed to load state

Error loading state: state snapshot was created by Terraform v1.9.5,
which is newer than current v1.5.7; upgrade to Terraform v1.9.5 or
greater to work with this state
Qui a décidé de la version de Terraform que fait tourner votre équipe ? Personne, en réalité. Un collègue a mis à jour son Terraform la semaine dernière, il a appliqué, et l’état a été réécrit dans un format que votre binaire ne sait plus lire. Vous êtes bloqué. Vous n’avez rien fait de mal, vous avez juste installé Terraform six mois avant lui.
Ce n’est pas grave, ça se règle en dix minutes. Mais c’est le petit bout visible d’un truc beaucoup moins sympathique.
Non, le problème ce n’est pas le verrou
C’est la première chose qu’on me sort, alors autant l’évacuer tout de suite. « Deux personnes qui appliquent en même temps, ça va casser. » Oui. Et c’est le seul point qui soit déjà résolu.
Un backend distant avec verrouillage, un bucket S3 et une table DynamoDB, ou l’équivalent chez votre fournisseur, et c’est réglé. Le deuxième attend, ou se prend un message clair :
Error: Error acquiring the state lock

Lock Info:
  ID:        4f2a9c11-8e3b-4d7a-b0c2-1e5f8a9d3b47
  Operation: OperationTypeApply
  Who:       marc@MacBook-Pro-de-Marc.local
  Created:   2026-08-19 14:32:05.812 +0200 CEST
Regardez bien la ligne Who. Elle ne dit pas quel code tourne, ni depuis quelle branche, ni si le disque de Marc était propre. Elle dit juste que c’est Marc, depuis son portable.
Le verrou empêche deux personnes d’écrire en même temps. Il n’empêche personne d’écrire n’importe quoi.
Le vrai problème : votre dépôt ne décrit plus la production
Voilà ce qui compte, et tout le reste en découle.
Quand j’applique depuis mon poste, j’applique ce qu’il y a sur mon disque. Pas ce qu’il y a sur main. Et entre les deux, il y a toujours quelque chose : une branche que je teste, une variable que j’ai passée en ligne de commande, un fichier que j’ai modifié pour voir et que je n’ai pas committé.
Le scénario est toujours le même, et je l’ai vécu plus d’une fois. Vous testez une ressource depuis une branche, ça marche, vous êtes content. Vous passez à autre chose. La branche n’est jamais mergée — pas par négligence, juste parce que la priorité a changé le jeudi suivant. La ressource, elle, existe bel et bien en production.
Six mois plus tard, quelqu’un applique depuis main pour une modification sans rapport, et Terraform lui propose gentiment de détruire un truc dont il n’a jamais entendu parler. C’est exactement l’écart dont je parlais dans l’article sur la dette technique, et vous connaissez la suite : personne ne corrige, tout le monde arrête de lancer terraform plan.
Et maintenant je vais aller plus loin, parce qu’on se rassure trop vite en se disant qu’il suffit de travailler proprement depuis main. Non. Appliquer depuis un main impeccable produit du drift aussi.
Votre main local n’est pas le main du dépôt. Il l’était ce matin. Depuis, deux collègues ont mergé. Vous lancez l’apply sans avoir tiré, Terraform lit ce qu’il a sous les yeux, et il repasse consciencieusement la production dans l’état d’avant leurs modifications :
  # aws_autoscaling_group.workers will be updated in-place
  ~ resource "aws_autoscaling_group" "workers" {
      ~ max_size = 12 -> 6
    }
Ce 12 -> 6, c’est la capacité qu’une collègue a doublée mardi, mergée, revue, discutée en réunion. Vous venez de la diviser par deux sans le savoir, et rien ne vous a prévenu : Terraform a fait exactement ce que vous lui avez demandé. Personne n’a de raison de regarder, jusqu’au prochain pic de charge.
Ensuite, il y a l’apply qui s’arrête au milieu. Le wifi du train, le portable qui se met en veille, un Ctrl-C par réflexe en voyant passer une ligne qui fait peur. La moitié des ressources est créée, l’état est écrit à moitié, et la seule personne au courant, c’est vous. La CI peut échouer au milieu elle aussi, évidemment. La différence, c’est qu’elle laisse un job rouge que tout le monde voit, avec le log complet de ce qui était passé avant l’arrêt.
Le drift ne vient donc pas du fait qu’on travaille salement. Il vient du fait qu’un poste de travail n’a aucun moyen de savoir s’il est à jour, et aucune obligation de raconter ce qu’il a fait.
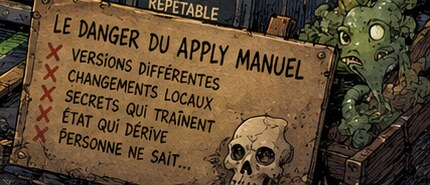
Posez-vous la question franchement : est-ce que le contenu de votre main décrit votre production, aujourd’hui, à la ressource près ? Si vous appliquez depuis les postes, la réponse honnête est que vous n’en savez rien. Vous savez seulement que ça a marché pour quelqu’un, un jour, avec ce qu’il avait sur son disque.
Un dépôt d’infrastructure as code dont personne ne peut garantir qu’il décrit la production, ce n’est plus de l’infrastructure as code. C’est de la documentation. Et on a vu ce que valait la documentation.
Et tout ce qu’il faut avoir sur son poste
On parle de Terraform, mais Terraform tout seul ne fait rien. Pour appliquer depuis votre machine, il vous faut, dans le désordre :
- la bonne version de Terraform, et souvent deux ou trois en parallèle selon les dépôts, donc un gestionnaire de versions par-dessus ;
- le CLI du fournisseur, configuré, avec les bons profils et le double facteur qui va avec ;
- le VPN, parce que le backend d’état n’est évidemment pas exposé sur internet ;
- les clés de déchiffrement des secrets, celles qu’on se transmet de la main à la main et que personne n’ose faire tourner ;
kubectlet son contexte,helm, et les deux ou trois outils maison que quelqu’un a écrits en 2021 ;- et surtout, des droits d’écriture sur à peu près tout.
Ce dernier point mérite qu’on s’y arrête, parce qu’on l’accepte sans jamais le formuler. Pour appliquer, il faut pouvoir créer et détruire. Donc chaque poste capable d’appliquer est un poste d’administrateur. Vous n’avez pas quatre ingénieurs qui font de l’infrastructure, vous avez quatre comptes tout-puissants qui se déplacent en train.
Et puis un jour vous perdez la machine. Vol, disque mort, ou simplement un renouvellement de parc un lundi matin. Là vous découvrez ce que ça représentait vraiment.
Ce n’est pas une réinstallation, c’est une fouille. Vous retrouvez Terraform en dix minutes. Le reste vous prend la semaine : le profil qui n’était configuré que chez vous, la variable d’environnement exportée dans un .zshrc que vous n’avez jamais versionné, la clé de déchiffrement qu’il faut redemander à quelqu’un qui est en congés, le certificat VPN qui passe par une demande interne à trois validations. Pendant cinq jours, vous ne pouvez rien appliquer, et vous passez vos journées à demander plutôt qu’à produire.
C’est exactement la fatigue dont je parlais à propos de l’arrivée dans une équipe : celle de chercher, pas celle de construire. Sauf que là, vous n’êtes pas nouveau. Vous êtes la personne qui tient la plateforme, et vous êtes hors-jeu une semaine parce qu’un disque a lâché.
Un job de CI, lui, repart de zéro à chaque exécution et il a tout. Ce n’est pas du confort : ça veut dire que la capacité d’appliquer n’appartient plus à des machines et à des gens, elle appartient au dépôt.
Et les clés qui dorment sur les portables
L’autre morceau, c’est la sécurité, et celui-là est plus brutal.
Pour appliquer depuis son poste, il faut des identifiants sur son poste. Concrètement, quatre ~/.aws/credentials avec des clés longue durée qui traînent sur quatre portables, qui partent en télétravail, qui vont au café, et qui se font parfois voler. Vous savez, vous, ce que peut faire exactement la clé qui dort sur le portable de votre collègue ? Ces clés-là ne tournent jamais, personne ne sait vraiment ce qu’elles ont le droit de faire, et je vous parie une bière qu’au moins une des quatre a des droits d’administrateur « parce que sinon ça ne marchait pas ».
Vous avez lu ce que fait un faux recruteur avec un dépôt piégé ? Le fichier qu’il cherche en premier sur votre machine, c’est précisément celui-là.
La CI n’a pas ce problème, à condition de la brancher correctement. Avec de la fédération d’identité, le job échange le jeton du pipeline contre des identifiants temporaires, valables une heure, limités à un rôle et à un dépôt précis. Il n’y a plus de secret stocké nulle part, ni sur les portables, ni dans les variables du projet. Rien à voler.
C’est franchement l’argument le plus facile à faire passer auprès d’une direction, et c’est un peu dommage. Parce que ce n’est pas le plus important.
Ce que la CI vous rend
Le plus important, c’est que la CI vous redonne quelque chose que vous n’aviez jamais eu côté infrastructure.
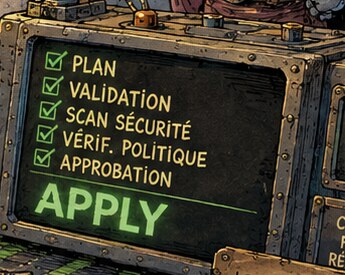
J’écrivais récemment qu’il n’existe pas de revue de code pour une machine, qu’on relit le code d’un développeur mais jamais un dimensionnement de cluster. Un pipeline qui fait le plan sur la merge request, c’est exactement ça : la fabrication d’une revue de code pour l’infrastructure.
Le plan devient une pièce jointe à la discussion. Il est lisible par quelqu’un d’autre que celui qui a écrit la modification. Il dit noir sur blanc ce qui va être créé, modifié et détruit, avant que ça arrive. Le nombre de fois où un collègue m’a dit « attends, pourquoi il veut remplacer l’instance ? » en lisant un plan que je n’avais pas lu assez attentivement, je ne les compte plus.
Et vous, à quand remonte la dernière fois où quelqu’un a relu un plan avec vous avant que vous l’appliquiez ?
Le reste vient par-dessus, presque gratuitement :
- une seule version de Terraform et des providers, celle de l’image du job, la même pour tout le monde et pour toujours ;
- une trace complète et non négociable : quel commit, quel auteur, quelle merge request, quel plan, à quelle heure — sans que personne ait à y penser ;
- les applies sérialisés par la file d’attente du pipeline, ce qui rend le verrou presque décoratif ;
- un nouveau qui arrive n’a rien à installer. Il clone, il propose une modification, il lit le plan dans son navigateur. Le premier jour, pas le troisième mois.
Ce dernier point est celui que je trouve le plus sous-estimé. Une équipe où seules deux personnes ont « le setup qui marche », c’est une équipe qui ne peut pas grandir.
« Oui, mais la CI c’est lent »
C’est vrai, et je ne vais pas faire semblant du contraire.
Itérer sur un module en attendant trois minutes de pipeline à chaque essai, c’est insupportable, et personne ne le fera. Les gens qui vous disent le contraire n’ont jamais écrit de module Terraform un vendredi après-midi.
Sauf que la règle n’a jamais été d’interdire Terraform sur les postes. Elle est beaucoup plus étroite que ça :
Le poste de travail fait le plan. La CI fait l’apply.
Faites tous les plans que vous voulez en local, autant que vous voulez, c’est même comme ça qu’on travaille correctement. Donnez à vos ingénieurs un rôle en lecture seule sur le poste, ça suffit largement pour planifier, et ça ne peut rien casser. Ce qui ne part jamais d’un portable, c’est l’écriture.
Deuxième objection, plus sérieuse : déboguer un pipeline, c’est pénible. Aucune commande interactive, des logs qu’on lit après coup, une boucle de retour épouvantable. La parade que j’utilise, c’est de faire tourner en local exactement la même image de conteneur que le job. Vous gardez le confort du shell et vous éliminez le « chez moi ça marche », qui est de toute façon la moitié du problème d’origine.
L’œuf, la poule, et le jour où la CI est en panne
Deux réserves honnêtes, parce qu’un article qui n’en a pas est un article qui ment.
La première, c’est l’amorçage. Le bucket qui stocke l’état, le rôle que la CI va endosser, la relation de confiance entre votre forge et votre fournisseur : tout ça doit bien exister avant que le premier pipeline puisse tourner. Ça se fait à la main, une fois. Ne perdez pas trois semaines à chercher la pureté sur ce point, personne ne l’a. Créez-le à la main, écrivez les dix lignes qui expliquent comment vous l’avez fait, et passez à la suite.
La seconde, c’est la panne. Un jour votre forge sera indisponible pendant que la production brûle, et ce jour-là vous serez très content d’avoir un chemin de secours. Prévoyez-le, nommez-le, mettez les identifiants dans un coffre avec une durée de vie courte, et faites en sorte que l’utiliser déclenche une alerte et une note quelque part.
Le but n’a jamais été d’empêcher qui que ce soit d’appliquer en urgence. Le but, c’est que ça se voie.
En conclusion
Si vous ne retenez qu’une phrase : le poste de travail fait le plan, la CI fait l’apply.
Mais le vrai sujet n’est pas l’outillage. Quand on demande qui a le droit de faire apply, on demande en réalité ce que vaut le dépôt. Tant que l’écriture part des postes, il vaut ce que vaut le disque dur de la dernière personne à l’avoir lancé. Dès que l’écriture passe par la CI, main devient la production, au sens strict, et tout le monde peut s’appuyer dessus sans avoir besoin de faire confiance à personne en particulier.
C’est ça qu’on achète. Pas de la conformité, pas un tableau de bord de plus. Le droit de croire ce qu’on lit dans le dépôt.
Une infrastructure as code qu'on ne peut pas croire, c'est juste du YAML avec des ambitions.